Обсудить пилот

AI SRE для Linux-инфраструктуры · Для DevOps и SRE

Мониторинг нашёл проблему. AutoDevOps выясняет почему.

AutoDevOps автоматически расследует инфраструктурные инциденты: собирает метрики, логи и состояние серверов, проверяет возможные причины и показывает выводы с доказательствами. Инженер видит, что подтверждено, что остаётся гипотезой и что проверить дальше.

Read-only диагностикаРазвёртывание на вашей инфраструктуреРаботает с вашим Prometheus / VictoriaMetrics

Пилот бесплатно. Расходы на LLM оплачиваются отдельно. Работает на проде у трёх компаний. Подробнее для руководителя

Демо · расследование по алертудемонстрационные данные

Посмотрите, что получает инженер вместо голого алерта.

Выберите типовой инцидент и проследите путь от сигнала до отчёта с проверяемыми доказательствами.

    Как это выглядит в продукте

    Почему выводам можно доверять

    Не просто ответ AI. Расследование, которое можно проверить.

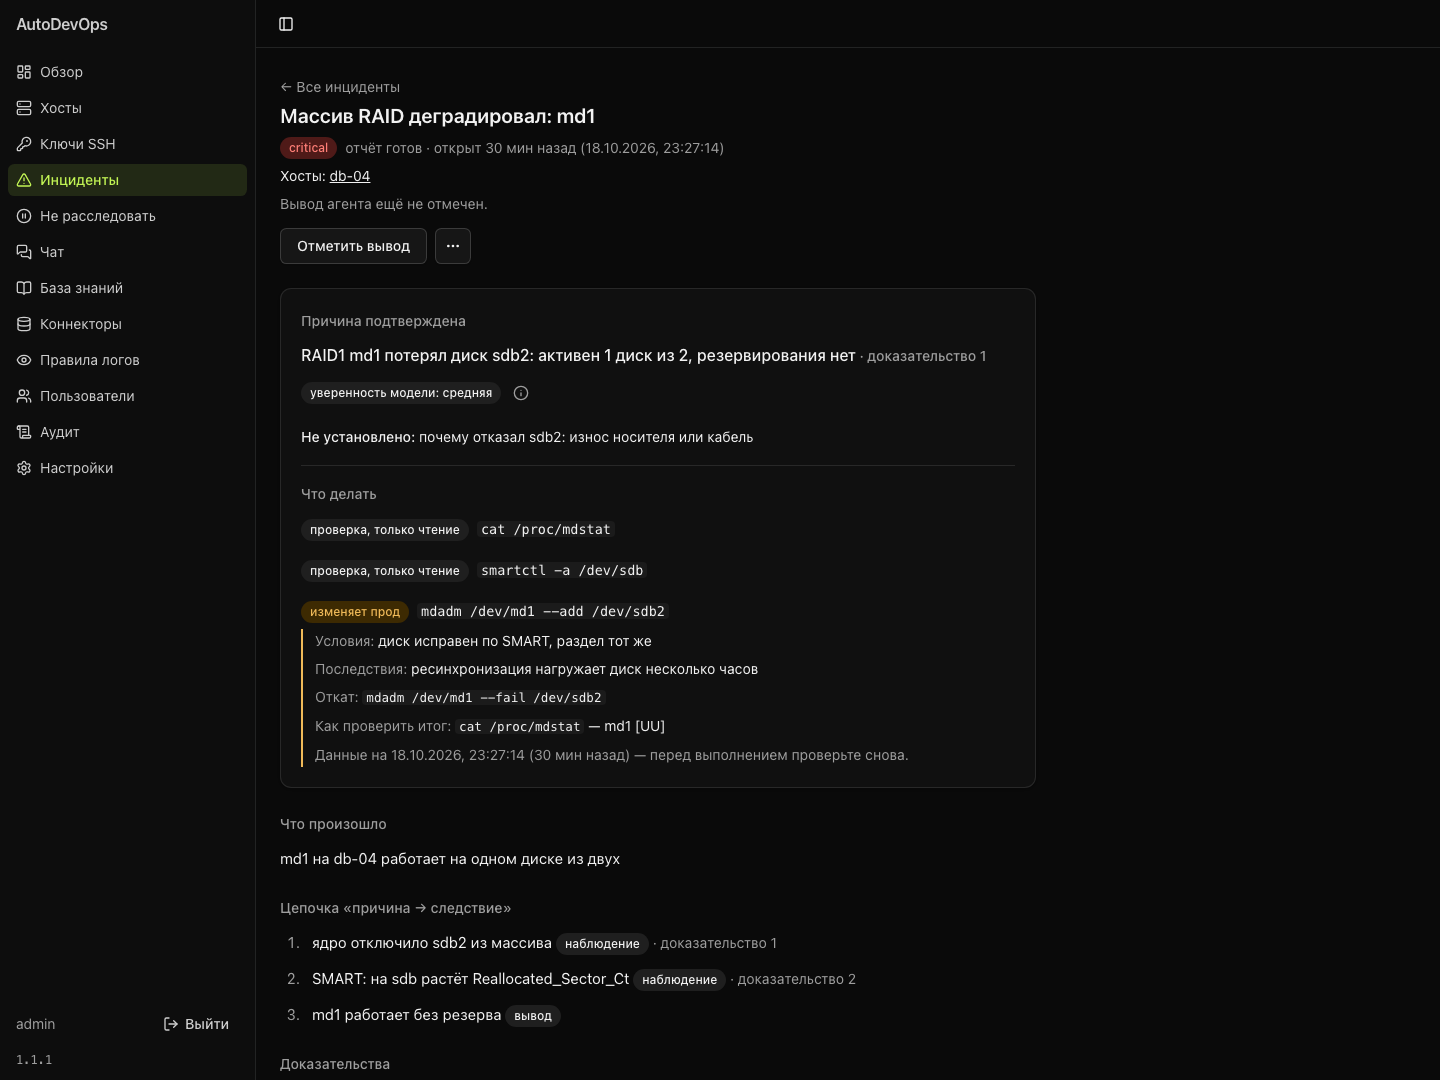
    Факт отдельно от гипотезы. У каждого важного вывода есть источник; неизвестное остаётся неизвестным.

    Доказательства → Что не установлено → Безопасные проверки → Изменяющие действия (только по решению инженера).

    Факты, выводы и гипотезы обозначены отдельно. Каждый важный вывод можно сопоставить с источником, открыть нужные исходные данные и продолжить расследование.

    Карточка инцидента AutoDevOps: подтверждённая причина и её доказательство, что не установлено, проверки и изменение с условиями и откатом
    Карточка инцидента в Web UI. Причина и её доказательство, что не установлено, проверки отдельно от изменения — с условиями и откатом. Данные — пример.

    Источник у каждого вывода

    Доказательство называет источник, объект и время и дословно цитирует вывод инструмента. Мастер сверяет цитату с тем, что инструмент вернул: цитата, которой в выводе нет, в отчёт не принимается. Ссылка из доказательства открывает нужную вкладку хоста — журнал юнита за окно инцидента, SMART, диски; в технических деталях — вызовы инструментов, модель и стоимость. «Глубже» под отчётом и чат в Web UI, Slack, Telegram и Zulip продолжают расследование с контекстом инцидента; удачные выводы агент предлагает в базу знаний — статья попадает туда после одобрения инженером.

    Факт, вывод, гипотеза, «не установлено»

    Причина помечена: подтверждена наблюдением, выведена из наблюдений или остаётся гипотезой. Чего агент не выяснил, так и написано — неизвестное не заполняется догадкой. Уверенность — оценка модели с пояснением, а не вероятность.

    Проверка отдельно от изменения

    Советы помечены по виду: только читающая команда, изменение с условиями, последствиями и откатом, или ручное решение. Опасная команда не выглядит как безобидная проверка, и ни одну команду агент не выполняет сам.

    Как работает

    Детектор решает, есть ли проблема. Модель объясняет почему.

    Всё, что можно описать заранее, делает код: панель, детекторы, снимки хостов, склейка сигналов в инцидент. Языковая модель вызывается только по сигналу или из чата.

    1. Сигнал

      Алерт Alertmanager, аномалия метрик, правило по логам journald или контейнера, проверка RAID, SMART и места на диске.

    2. Инцидент

      Близкие сигналы одного хоста склеиваются в один инцидент. Шум можно поставить на паузу.

    3. Проверка

      Агент спрашивает хосты, метрики и базы через read-only инструменты в пределах бюджета.

    4. Отчёт

      Причина, доказательства с цитатами, что проверить и что менять — в канал по правилам хоста.

    5. Решение инженера

      Инженер проверяет, отмечает «верно / неверно / шум» и действует сам.

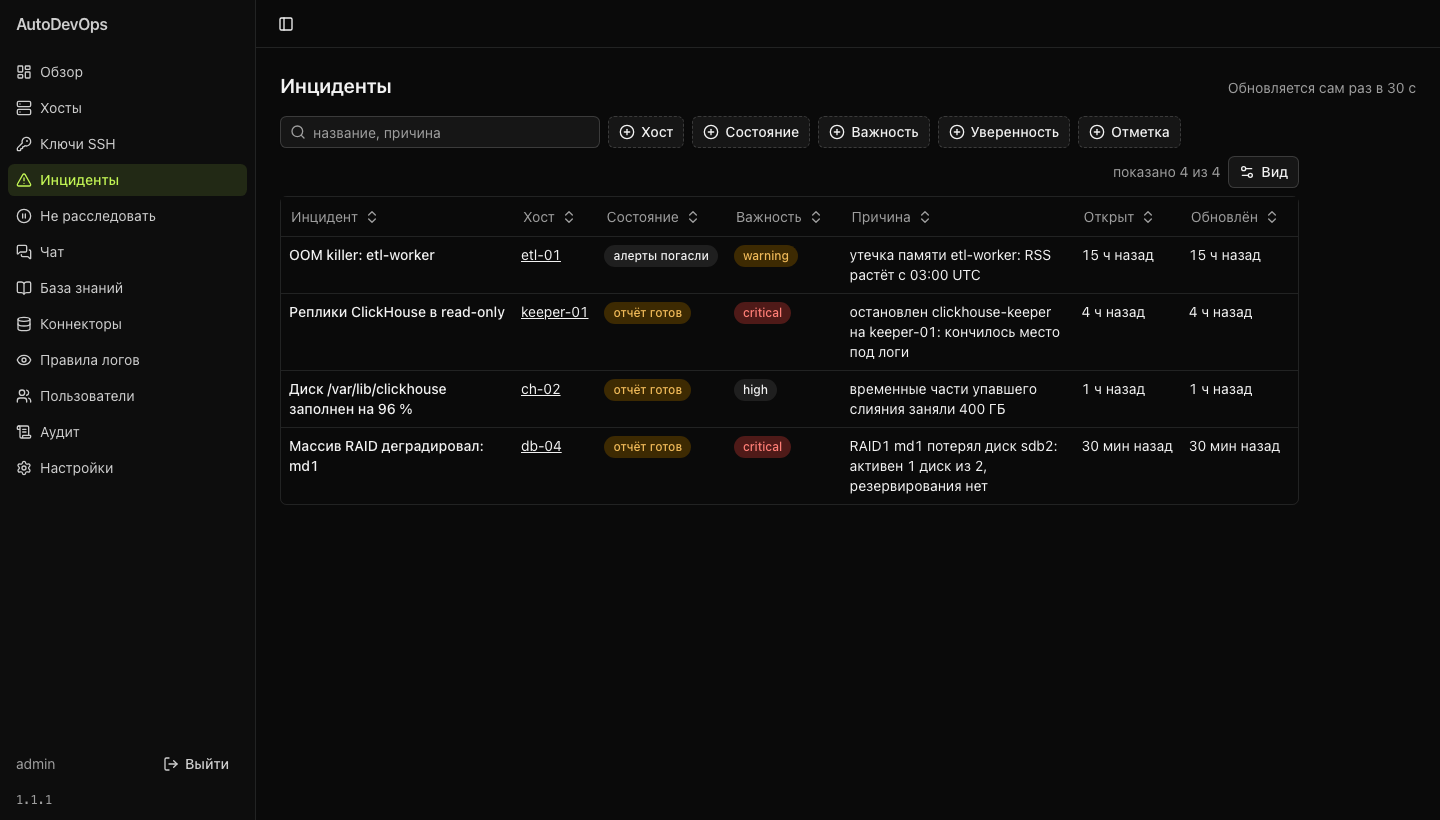
    Список инцидентов AutoDevOps: причина, важность и состояние каждого
    Список инцидентов: у каждого — причина, важность и как он закрыт. Данные — пример.

    Что ещё есть в продукте

    Расследованию нужен контекст — тот же контекст инженер видит сам, без ssh и без LLM.

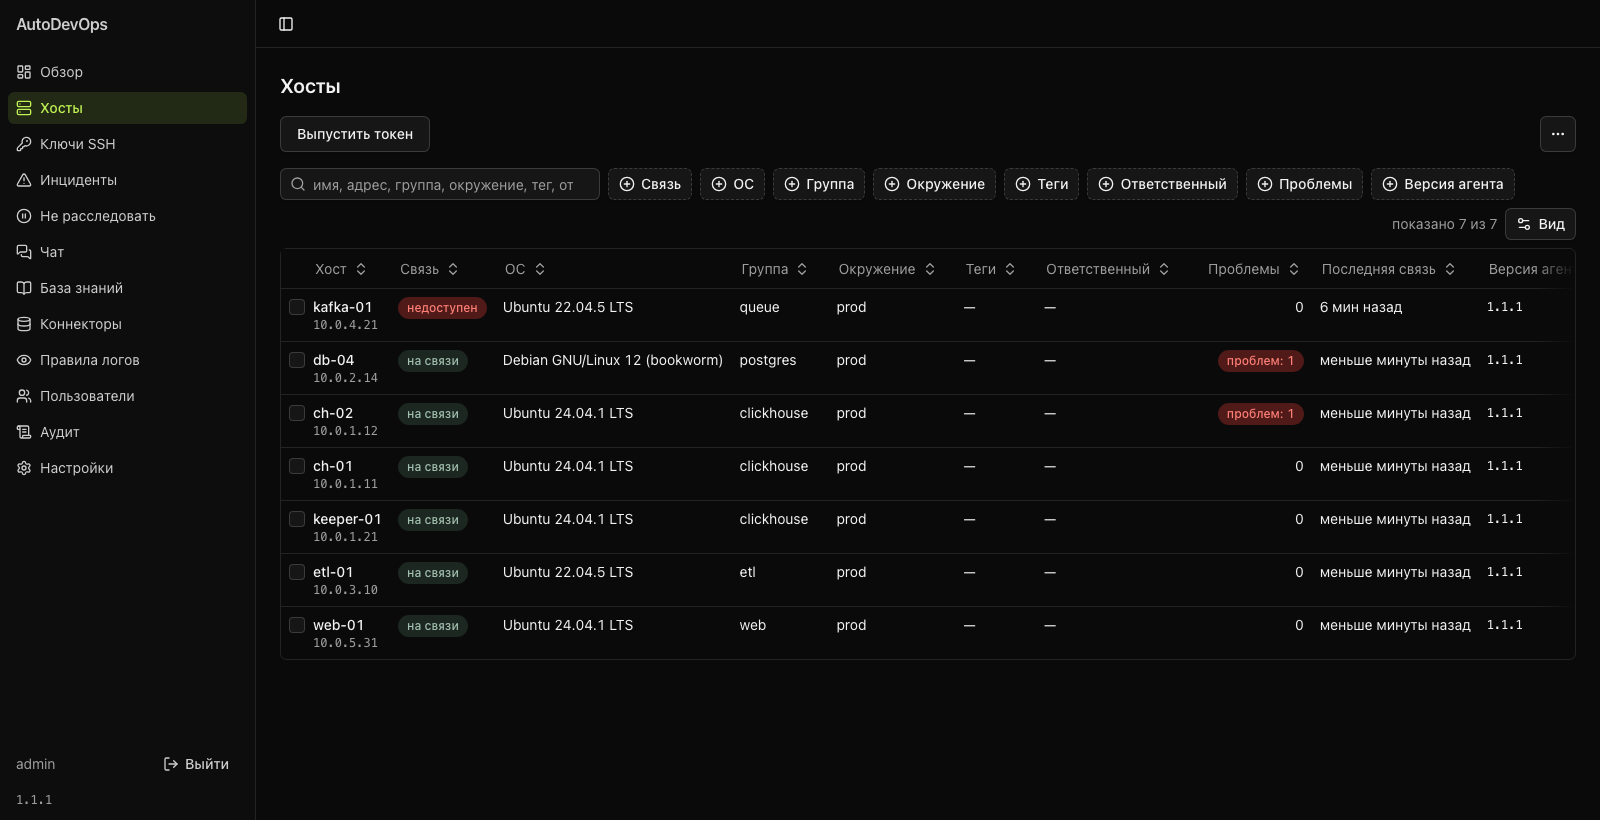
    Экран «Хосты» AutoDevOps: недоступный хост и хосты с проблемами — сверху
    Экран «Хосты». Недоступные и хосты с проблемами — сверху. Данные — пример.
    РесурсыПортыЖурналПроцессыСервисыПланировщикПакетыДиски и RAIDSMARTСистемаСетьFirewallДоступПользователи и ключиКонтейнеры

    Состояние хостов

    Утренний обход — одно окно вместо десятка вкладок и ssh по серверам: недоступные и хосты с проблемами — сверху. Это код, а не модель: отвечает за секунды и одинаково каждый раз.

    Проактивные детекторы

    Аномалии метрик, зависшие транзакции и ожидание блокировок PostgreSQL, правила по логам journald и контейнеров — мастер сам открывает инцидент, без правил в Alertmanager. Исключения и пауза — по хостам, группам и тегам.

    Диагностика Linux/RAID/SMART

    Деградировавший RAID, файловая система за 85 % или в read-only, диск, который SMART помечает как отказывающий, — проблемы снимка хоста сами становятся инцидентом. Процессы, сервисы, порты, пакеты, firewall — во вкладках хоста.

    PostgreSQL и ClickHouse

    Запросы только с мастера, под read-only учёткой. ClickHouse — каждый узел кластера: ошибки и тяжёлые запросы за окно инцидента. PostgreSQL — активность сессий и кто кого держит в ожидании блокировки.

    Журналы и контейнеры

    Журнал юнита, логи контейнера, ошибки ClickHouse за окно инцидента читаются прямо с хоста. Мастер их не хранит и не копит.

    Доступ/ключи

    SSH-ключ уволенного находится по отпечатку или комментарию на всех хостах сразу, вместе с файлом и пользователем.

    Для руководителя

    Ваши инженеры должны устранять проблемы, а не собирать контекст по десяти системам.

    AutoDevOps автоматизирует часть начальной диагностики и даёт команде проверяемый контекст по инциденту. Насколько это экономит время именно у вас — измерим во время пилота.

    • Меньше повторяющейся работы

      AutoDevOps берёт на себя часть начального сбора и сопоставления данных: состояние Linux-хостов, метрики, журналы и сведения о базах данных.

    • Знания становятся доступнее команде

      Структурированные доказательства и предлагаемые проверки помогают инженерам продолжать расследование без полной зависимости от одного специалиста, который знает всю инфраструктуру.

    • Контролируемый риск

      Проверки выполняются read-only инструментами; модель не получает произвольный shell и не применяет исправления в продакшене. Решение и изменяющие действия остаются за инженером.

    Не обещаем абстрактные −70% MTTR. Предлагаем измерить влияние на ваших инцидентах в пилоте.

    Цель пилота — измерить время до полезного контекста, точность выводов, стоимость LLM и усилия на внедрение.

    Калькулятор потенциальной экономии

    Оценить эффект для команды. Все значения — ваши предположения; значения по умолчанию — примерные значения, измените под себя.

    40
    20 мин
    $50

    Высвобожденное время

    13,3 ч/мес.

    Потенциальный эквивалент

    $667/мес.

    Сценарный расчёт, не измеренный результат AutoDevOps. Не равен сокращению фонда оплаты труда. Эффект необходимо подтвердить на пилоте. Это оценка стоимости высвобожденного рабочего времени, а не гарантированная денежная экономия или ROI. Для чистого эффекта нужно вычесть лицензию, инфраструктуру, LLM и сопровождение.

    Передайте руководителю

    Предлагаю протестировать AutoDevOps — инструмент для автоматического расследования инфраструктурных инцидентов на наших Linux-серверах. Он подключается к существующему мониторингу, собирает технический контекст и формирует проверяемый отчёт с доказательствами. Исправления автоматически не применяет. Предлагаю провести ограниченный бесплатный пилот и измерить время до полезного контекста, точность выводов, затраты на LLM и трудозатраты на внедрение. Обработка LLM выполняется через OpenRouter с передачей данных расследования после маскирования секретов. По результатам примем решение, стоит ли масштабировать решение и приобретать лицензию.
    Скачать PDF · 1 страница Обсудить пилот

    Чем отличается от облачных AI SRE

    AutoDevOpsОблачные AI SRE
    Где работаетМастер и данные — на ваших серверах; в модель — данные расследования через OpenRouter после маскирования секретовПлатформа и данные — в облаке вендора
    Оплата расследованияМодель — по вашему ключу и с дневным лимитом: ≈ $0,24 на контрольных прогонахОт $4 за расследование по официальным прайсам
    Что агент может на продеТолько читать: нет shell и операций записиУ части — автоматические действия
    Состояние хостовПанель всего парка без LLM, проблемы снимков — сами в инцидентыТолько расследования поверх вашего мониторинга

    Архитектура и безопасность

    Подключается к вашему стеку. Не получает права менять прод.

    Master работает на вашей инфраструктуре, агенты выполняют только фиксированные диагностические проверки. Языковая модель получает контекст расследования через выбранного провайдера; секреты маскируются перед передачей. Изменения выполняет только инженер.

    1. Существующий мониторинг и Linux-агентыPrometheus или VictoriaMetrics, Alertmanager; агент на хосте сам открывает исходящее mTLS-подключение.
    2. Master в сети клиентаСклеивает сигналы, маскирует секреты на входе, хранит инциденты и аудит.
    3. Read-only расследование и проверкаФиксированный каталог проверок хоста, PromQL, SQL под read-only учёткой.
    4. При вызове LLM — через OpenRouterОбработанные сведения после маскирования секретов. Модель и дневной лимит — ваши.
    5. ОтчётВ Web UI или мессенджере.
    6. Решение инженераИзменения выполняет только человек.

    Мастер разворачивается у вас. Для работы выбранной языковой модели часть данных расследования передаётся через OpenRouter после маскирования секретов.

    Технические подробности: 8 механизмов защиты
    • Только чтениеАгент ничего не меняет на хостах и не обновляет себя: обновление — через apt.
    • Ни одного входящего порта на хостеАгент сам открывает исходящее соединение с мастером по mTLS. Сертификат хоста живёт сутки.
    • Нет shellТолько фиксированный каталог проверок, вшитый в бинарник. Модель не может выполнить произвольную команду.
    • Разделение привилегийСетевой процесс без прав. Привилегированная часть — без сети и с закрытым списком операций.
    • Базы — под read-only учёткойSQL идёт только с мастера: ClickHouse с readonly=1, PostgreSQL с pg_monitor.
    • Секреты — в OpenBaoПароли и токены заменяются на входе мастера, до базы и LLM. Креды хранятся в OpenBao.
    • Журнал только на дозаписьКаждый вызов инструмента и модели — в аудит: кто, что, когда.
    • Роли, доступ по группам хостов, лимит затратНаблюдатель, инженер, администратор; вход через Keycloak по OIDC; дневной лимит расходов на модель.

    Совместимость

    Встаёт поверх мониторинга, который у вас уже есть: мастер не хранит логи и историю метрик, а спрашивает ваш Prometheus. Для мастера хватает одной ВМ.

    ХостыUbuntu 20.04, 22.04, 24.04 · Debian 12 · железо и ВМ, в том числе за NAT
    Метрики и алертыPrometheus или VictoriaMetrics · Alertmanager · node_exporter
    Базы данныхClickHouse (каждый узел кластера) · PostgreSQL 16 и 18
    МессенджерыSlack · Telegram · Zulip — на одном мастере, без входящих webhook
    МодельМодель через OpenRouter, выбирается в настройках (по умолчанию советуем Claude Sonnet 5.5) · дневной лимит расходов
    УстановкаАгент — deb-пакет и роль Ansible · мастер — Docker Compose на вашей ВМ
    KubernetesВ разработке — поддержка появится в следующих версиях.

    Измерено

    Проверяйте результат на своих инцидентах.

    Бесплатный пилот на вашей инфраструктуре, без замены существующего мониторинга. Проверим полезность автоматических расследований на реальных условиях вашей команды.

    Случай с прода: блокировка в PostgreSQL

    Реальный инцидент компании, где AutoDevOps работает на проде. Имена пользователей, представлений и адреса заменены; номера процессов, время и тип ожидания — как в источнике.

    Условия

    Аналитический отдел: PostgreSQL на железном сервере, отчёты BI-сервера (Tableau) читают материализованные представления. Блокировки в PostgreSQL напрямую влияют на нагрузку BI-сервера. AutoDevOps — на ВМ компании, к базе — под учёткой только на чтение.

    Сигнал

    Детектор мастера по коннектору PostgreSQL: две сессии ждут блокировку дольше минуты. Правила в Alertmanager для этого не понадобилось.

    Отчёт

    Через 18 секунд после сигнала, один вызов инструмента — pg_activity, $0,07 на модель. Уверенность модели — высокая.

    Подтверждено: сессия 83209 около 6 минут выполняет REFRESH MATERIALIZED VIEW public.mv_daily_report и держит блокировку представления; два читающих запроса ждут её около 2 минут.

    РольpidПользовательОжиданиеДлитсяЗапрос
    Держит83209etl_user—00:05:59REFRESH MATERIALIZED VIEW public.mv_daily_report;
    Ждёт83316analystLock / relation00:01:58SELECT … FROM mv_daily_report …
    Ждёт83320bi_service (Tableau)Lock / relation00:02:01SELECT … FROM mv_daily_report …

    Что делать — из отчёта:

    • дождаться окончания REFRESH и проверить длительность по pid 83209;
    • проверить, можно ли перейти на REFRESH MATERIALIZED VIEW CONCURRENTLY (нужен уникальный индекс) или запускать обновление в нерабочее время;
    • проверить, почему обновление идёт дольше 6 минут, и оптимизировать запрос представления.

    Отменить сессию агент не предлагал: решение остаётся за инженером.

    Подтверждение

    Инженер отметил вывод агента как «верно». Сигнал погас сам примерно через 30 минут — это не доказательство устранения причины, а конец ожидания.

    Результат

    Вручную путь идёт от симптома: сначала видно, что отчёты в Tableau подвисают, потом — что дело в PostgreSQL, и только потом инженер идёт в psql искать, кто кого держит. Здесь сигнал пришёл от самой базы, и цепочка «кто держит — кто ждёт» с запросом и временем была готова через 18 секунд. Оценка инженера команды: такой разбор вручную — около 15 минут и 5–15 команд. Это оценка, а не замер.

    18 из 18

    расследований на контрольном наборе — первопричина названа верно

    ≈ $0,24

    средняя стоимость модели на расследование в этих прогонах, Claude Sonnet 5.5. Не цена AutoDevOps

    0

    ложных фактов в названной причине на этих 18 отчётах

    Методика: шесть типовых аварий — ClickHouse ушёл в read-only, кончилось место на диске, CPU в полку, утечка памяти и OOM killer, лимит памяти запроса ClickHouse, потери пакетов в сети. Каждая прогнана трижды; отчёты оценены вслепую против эталона сценария. Это контролируемый набор, а не гарантия точности на проде.

    Что оцениваем в пилоте

    • время до первого полезного, подтверждённого контекста / гипотезы;
    • долю корректных и проверяемых выводов, причины ошибок и ложные выводы;
    • количество ручных проверок / переключений между инструментами, которые удалось исключить;
    • затраты LLM и реальные ограничения обработки данных;
    • усилия на интеграцию, поддержку и реакцию инженера.

    Как проходит пилот

    1. Master на ВМ клиента; установка через Ansible / Docker Compose.
    2. Агенты — deb-пакет из репозитория мастера.
    3. Prometheus / Alertmanager, выбранные мессенджер и LLM подключаются в UI.
    4. Первые расследования — по поступившим сигналам.
    5. Владелец продукта помогает на каждом шаге.

    Вопросы

    Что обычно спрашивают инженеры и руководители.

    Может ли агент что-то изменить на сервере?

    Нет. У агента нет shell и нет операций записи: только фиксированный каталог проверок. Команды из советов выполняет человек, если сочтёт нужным.

    Что уходит во внешнюю языковую модель?

    Ответы инструментов, которые агент запросил в ходе расследования, и текст алерта. Пароли, токены и ключи маскируются на входе мастера — до базы и до модели; маскирование ловит секреты по имени и известным формам, это не гарантия. Модель вызывается вашим ключом OpenRouter, и выбираете её вы — в том числе ту, что разрешена вашей политикой данных.

    Что если модель ошиблась?

    Отчёт обязан назвать источник каждого факта, и мастер сверяет цитаты с реальным выводом. Инженер видит все доказательства, перепроверяет их и отмечает отчёт как верный, неверный или шум.

    Куда ставится мастер и какие порты нужны?

    На вашу ВМ: Docker Compose, PostgreSQL, OpenBao. Входящие на мастер — Web UI по 443 и порт агентов (по умолчанию 18443); на хостах агент портов не слушает. Исходящие с мастера — мессенджер, OpenRouter, ваши Prometheus, Alertmanager и базы, плюс Let’s Encrypt, если сертификат Web UI не свой. Выход — можно через прокси компании.

    Сколько стоит пилот и что после него?

    Пилот бесплатный. Модель вы оплачиваете напрямую через OpenRouter и ограничиваете дневным лимитом в настройках. По итогам пилота у вас есть измеренные результаты на своих инцидентах — по ним вы решаете, продолжать ли.

    Какие ОС и базы поддерживаются?

    Хосты — Ubuntu 20.04, 22.04, 24.04 и Debian 12, железо и ВМ, в том числе за NAT. Базы — ClickHouse (каждый узел кластера) и PostgreSQL 16 и 18. Kubernetes — в разработке.

    Пилот

    Проверьте AutoDevOps на своих инцидентах.

    Бесплатный пилот. Мастер на вашей ВМ. Ваши метрики и существующий мониторинг. Оцените качество расследований и реальную стоимость на своей инфраструктуре.

    Обсудить пилот в Telegram Написать на почту mrchupatek@gmail.com

    Расходы на LLM оплачиваются отдельно и ограничиваются дневным лимитом.